RAG(検索拡張生成)とは|社内資料を使う仕組みと追加学習との違い

RAG(検索拡張生成)は、指定した資料から質問に関係する箇所を探し、その内容と質問を生成AIへ渡して回答を作る仕組みです。モデルを学習し直さず社内資料や最新情報を参照させる方法で、答え方を変えるファインチューニングとは役割が異なります。社内で使う担当者は、出典を示せても検索の質に回答が左右され、誤りは残ることを踏まえ、誰にどの資料を見せるかを先に決めましょう(2026年10月27日時点)。
出典:Microsoft Learn 取得強化生成(RAG)とインデックス/OpenAI Optimizing LLM Accuracy(2026年10月27日確認)。
RAG(検索拡張生成)とは何か?
RAGとは、生成AIに答えを作らせる前に資料を検索し、見つけた内容を回答の材料として渡す方法です。 Retrieval-Augmented Generationの略で、日本語では検索拡張生成と呼びます。
仕事に置き換えるなら、担当者がマニュアルを開き、質問に関係する箇所を確かめてから説明する流れに近いものです。AIが社内の決まりを丸暗記するのではなく、回答に必要な資料をその都度参照する点が中心になります。
各社と日本の公的資料が説明する焦点を、担当者が見る観点に置き換えると次のようになります。製品の性能比較ではなく、RAGという仕組みの説明を整理した表です。
| 説明の出所 | RAGを捉える視点 | 担当者が見る点 |
|---|---|---|
| Google Cloud | 情報を見つける機能と文章を作る機能をつなぐ | 自社の情報や新しい資料を回答の材料にする |
| Microsoft Learn | 検索で得た材料を言語モデルの回答へ結び付ける | 非公開の文書や改定される情報を参照させる |
| AWS | 学習時の情報とは別の資料を回答前に参照する | モデルを再学習せず知識を補う |
| OpenAI | 取得した内容を指示文へ加えてから回答を作る | 質問だけでなく答えの材料も渡す |
| 総務省・経済産業省 | 答えを出す段階で外部の知識を補う | 資料の参照とモデルの学習を区別する |
出典:Google Cloud 検索拡張生成(RAG)とは/Microsoft Learn 取得強化生成(RAG)とインデックス/AWS RAG(検索拡張生成)とは何ですか?/OpenAI Optimizing LLM Accuracy/総務省・経済産業省 AI事業者ガイドライン第1.2版 pp.10〜11(2026年10月27日確認)。
資料によっては「取得強化生成」「レトリーバル拡張生成」という表記も見られます。ここからは検索拡張生成に統一します。
出典:Microsoft Learn 取得強化生成(RAG)とインデックス/Microsoft Learn Azure AI 検索でのレトリーバル拡張生成(RAG)(2026年10月27日確認)。
この名前は、2020年の論文「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」で使われています。生成AIの最近の流行だけで生まれた呼び名と捉えるより、検索と生成を組み合わせる考え方として押さえると理解しやすくなります。
出典:arXiv Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(2026年10月27日確認)。
なぜ普通の生成AIは社内のことに答えられないのか?
学習済みの知識だけで答えるAIには、非公開の社内規程や、その後の改定内容を参照する材料がないからです。 一般的な仕事の説明ができることと、自社の決まりを知っていることは別です。
Google CloudやAWSは、モデルが学習時に得た情報に頼ると、新しい情報や組織固有の内容を回答へ反映しにくい点を説明しています。公開されている一般知識だけでは、会社ごとに異なる申請先や業務手順は埋まりません。
出典:Google Cloud 検索拡張生成(RAG)とは/AWS RAG(検索拡張生成)とは何ですか?(2026年10月27日確認)。
たとえば、就業規則について問い合わせる場面を考えます。欲しいのは世間一般の説明ではなく、自社の規則に照らした答えです。会社名や資料名を質問に書くことと、その資料の内容をAIに渡すことは同じではありません。
ここで切り分けたいのは、「AIが文章を組み立てられない」のか、「判断材料となる社内情報が足りない」のかです。後者なら、質問の言い方を細かくするだけでなく、どの資料を参照させるかを検討します。
RAGが補うのは、この資料との接点です。人が質問のたびに関係する箇所を選んで渡す作業を、検索と組み合わせた流れにします。会社の決定事項を、AIの一般知識から推測させる使い方とは分けて考えましょう。
RAGはどういう仕組みで動くのか?
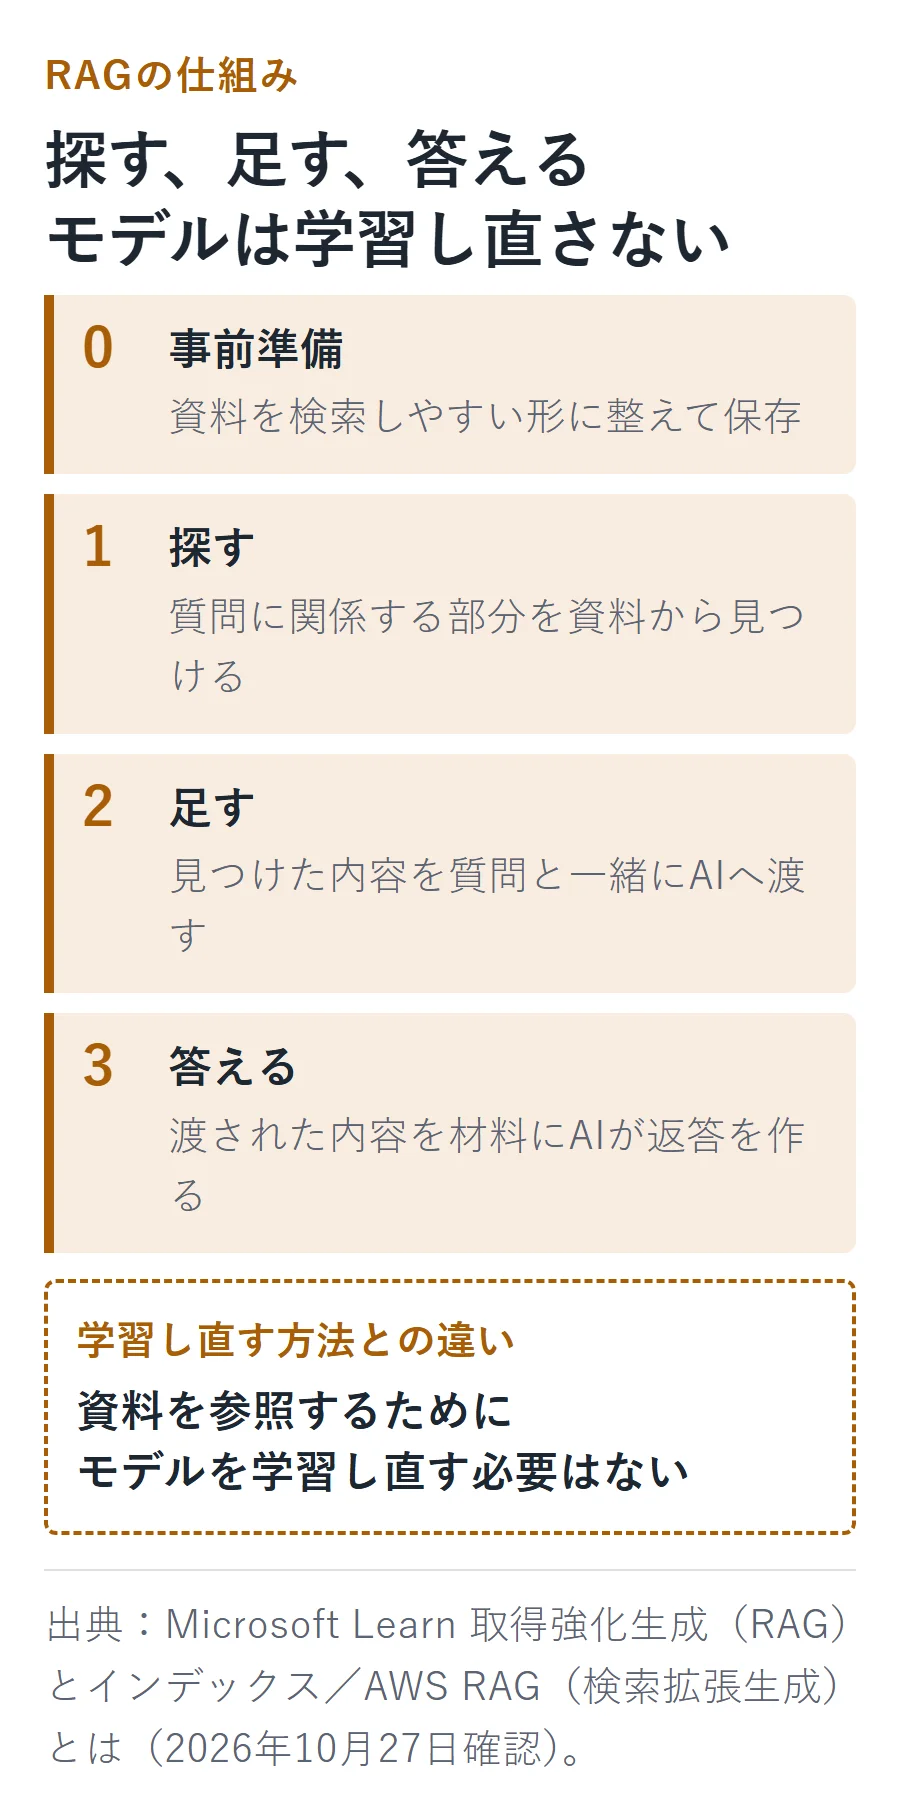
質問を受けた後の動きは「探す→足す→答える」の3段階です。 その前に、対象の資料を検索できる状態へ整える準備があります。
| 段階 | すること | 業務マニュアルを使うなら |
|---|---|---|
| 事前準備 | 資料を検索しやすい形に整理して保存する | 使う資料と最新版をそろえる |
| 探す(取得) | 質問に関係する部分を資料から見つける | 問い合わせに対応する手順を探す |
| 足す(拡張) | 見つけた内容を質問と一緒にAIへの入力へ加える | 質問と該当部分を同じ入力で渡す |
| 答える(生成) | 渡された内容を材料にAIが返答を作る | 手順を説明し、元の資料も示す |
出典:Microsoft Learn 取得強化生成(RAG)とインデックス/AWS RAG(検索拡張生成)とは何ですか?(2026年10月27日確認)。
表の業務例は、各社の説明を社内マニュアルに当てはめた整理です。利用者が質問を送る裏側で、検索する部分と、文章にまとめる部分がつながっています。AIが読むのは検索で選ばれた材料なので、資料を保存しただけで全体を把握させたつもりにならないことが大切です。
技術用語は、次の対応だけ押さえれば全体の流れを追えます。これは意味の近さで検索する構成の説明で、RAGの方式を一つに限定するものではありません。
- チャンク:長い資料を切り分けた小さなまとまり。
- 埋め込み(ベクトル化):文章の意味を、数値の並びで表す処理。
- ベクトルデータベース:意味が近いものを探すための保存先。
- インデックス:検索に使えるよう整理した索引。
出典:Anthropic Contextual retrieval in AI systems/AWS RAG(検索拡張生成)とは何ですか?/Microsoft Learn 取得強化生成(RAG)とインデックス(2026年10月27日確認)。
検索には、意味の近さを使う方法と、言葉の一致を使う方法があります。型番やエラーコード、規程番号のように文字そのものが大事な質問では、似た意味だけで探すと取りこぼすおそれがあります。意味による検索と語句の一致による検索を組み合わせる考え方もあるため、担当者は「どんな言葉で質問されるか」を具体的に伝えるとよいでしょう。
出典:Anthropic Contextual retrieval in AI systems/Microsoft Learn 取得強化生成(RAG)とインデックス(2026年10月27日確認)。
資料の改定後は、検索に使うデータも更新する運用が要ります。社内マニュアルを差し替えたことと、RAGが新しい内容を探せることを別々に確かめ、更新する担当を決めます。
出典:AWS RAG(検索拡張生成)とは何ですか?(2026年10月27日確認)。
Microsoft Learnは、複雑な問いを小さな検索へ分けて並行処理するエージェント型の検索も説明しており、関連する考え方はAIエージェントの仕組みと任せる範囲で整理しています。
出典:Microsoft Learn 取得強化生成(RAG)とインデックス(2026年10月27日確認)。
ファインチューニングとは何が違うのか?
RAGは回答に使う知識を資料から補い、ファインチューニングは追加の学習によってモデルの振る舞いを調整します。 社内の情報を答えに反映したいのか、書き方や作業のこなし方を変えたいのかで、検討する役割が違います。
| 判断軸 | RAG | ファインチューニング |
|---|---|---|
| 主に変えるもの | 質問とともに渡す資料 | モデルの答え方や作業の特性 |
| 検討する目的 | 社内の知識や更新される情報を参照させる | 文体や特定の作業への適応を変える |
| モデルの学習 | 資料を参照するために学習し直す必要はない | 学習済みのモデルに追加で学習を行う |
出典:Microsoft Learn 取得強化生成(RAG)とインデックス/AWS RAG(検索拡張生成)とは何ですか?/総務省・経済産業省 AI事業者ガイドライン第1.2版 p.10 脚注17(2026年10月27日確認)。
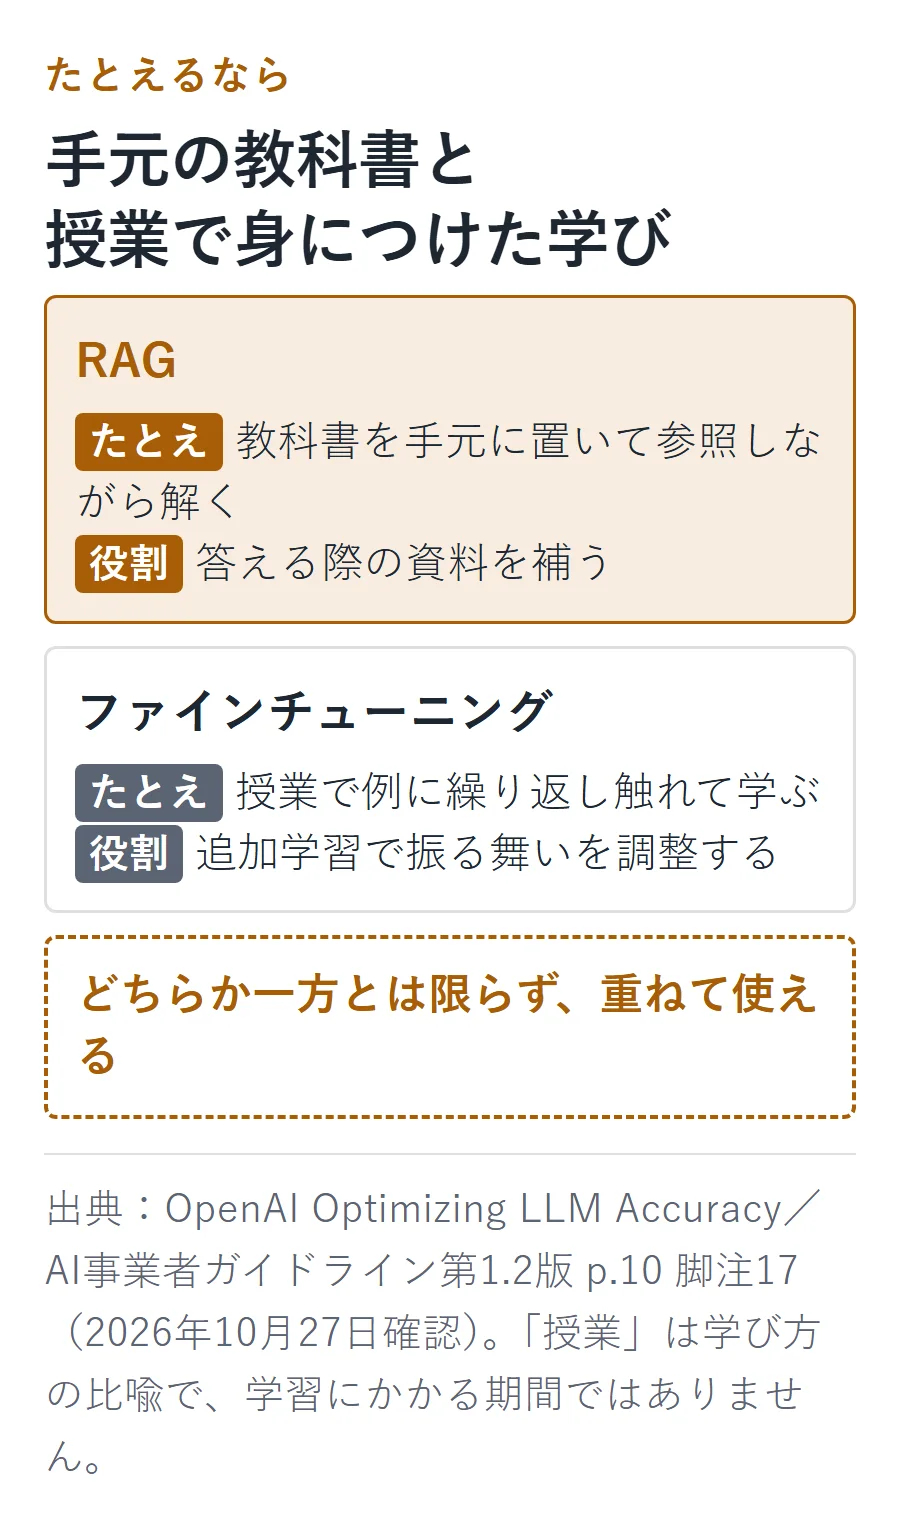
OpenAIのたとえでは、RAGは教科書を手元に置いて参照しながら解く形、ファインチューニングは半年の授業で例に繰り返し触れて学ぶ形です。この「半年」は学び方を表す比喩で、構築や学習にかかる期間ではありません。
出典:OpenAI Optimizing LLM Accuracy(2026年10月27日確認)。
国のAI事業者ガイドライン第1.2版は、学習済みモデルを用途に合わせてさらに学ばせる工程を「事後学習」として説明し、ファインチューニングをその手法の一つに挙げています。資料を読ませることを何でも「学習」と呼ぶと、検討したい作業が伝わりにくくなります。
出典:総務省・経済産業省 AI事業者ガイドライン第1.2版 p.10 脚注17(2026年10月27日確認)。
また、どちらか片方に決める必要もありません。OpenAIは、両方を重ねて使う考え方を示しています。
These two optimization methods are additive, not exclusive - they stack, and some use cases will require you to use them together to use optimal performance.
出典:OpenAI Optimizing LLM Accuracy(2026年10月27日確認)。
筆者訳:この二つの方法は排他的な選択肢ではなく、重ねて使えます。性能を引き出すために、両方を組み合わせる必要がある用途もあります。
社内規程の内容を知ってほしい依頼と、回答の文体をそろえてほしい依頼は分けて伝えます。書式や文体の問題なら、追加学習を決める前に指示の工夫で対応できるかを見る観点もあります。AIプロンプトの書き方と改善のコツは、その入力側を見直すための手掛かりです。
RAGを使うと何が良くなるのか?
社内の情報を回答の材料にでき、根拠となった資料へ人が戻れる点が利点です。 更新された資料を検索対象へ反映すれば、モデルの学習時点だけに縛られずに情報を使えます。
導入の目的は、次のように業務へ引き寄せて整理できます。
- 一般論でなく、自社の資料を参照させる:規程やマニュアルに沿って問い合わせへ答えるための材料を渡します。
- 答えだけでなく、その根拠も受け取る:元の文書を示すことで、担当者が何をもとにした回答かを確かめられます。
- 情報を足すための再学習を避ける:AWSは、組織の情報を追加するためにモデルを再学習する方法と比べ、RAGの費用面での利点を挙げています。
出典:AWS RAG(検索拡張生成)とは何ですか?/Microsoft Learn 取得強化生成(RAG)とインデックス(2026年10月27日確認)。
費用の比較対象は、モデルを学習し直して組織の情報を加える方法です。どんな構成でも安く仕上がるという意味へ広げず、資料を検索して使う方式の利点として読みます。
仕事での使い道を考えるなら、回答を受け取った人が元資料へ戻れることが重要です。説明文だけを渡すより、参照箇所を一緒に扱えば、会社の規程と答えの対応を点検するための手掛かりが残ります。出典は回答にお墨付きを付ける飾りではなく、人が確かめるための入口です。
国のガイドラインも、期待する効果を次のように記しています。
RAG(検索拡張生成)の活用等により、ハルシネーションの抑制や出力過程・根拠の透明性向上等が期待されている。
出典:総務省・経済産業省 AI事業者ガイドライン第1.2版 p.15 脚注27(2026年10月27日確認)。
読み取れるのは、誤りを減らし、何を根拠にしたかを見えやすくするという期待です。RAGを入れたことだけを理由に、人が内容を見る工程をなくす説明ではありません。
RAGでも間違えるのはどんなときか?
必要な資料を見つけられないとき、無関係な内容を渡しすぎたとき、資料を分けて文脈が失われたときです。 検索が付いていても、答えの材料が適切かという問題は残ります。
OpenAIは、回答に渡す情報について次のように注意しています。
You can supply the wrong context, so the model can’t possibly answer, or you can supply too much irrelevant context, which drowns out the real information and causes hallucinations.
出典:OpenAI Optimizing LLM Accuracy(2026年10月27日確認)。
筆者訳:誤った文脈を渡せばモデルは答えようがなく、無関係な文脈を多く渡しすぎると、本当の情報が埋もれてハルシネーションの原因になります。
「資料を増やせば答えも良くなる」と単純には考えられません。たとえば、質問の対象と違うマニュアルが選ばれたら、AIがその内容を丁寧に説明しても仕事で欲しい答えにはなりません。Google Cloudも、取得した情報が質問と合わなければ、回答に誤りが生じるおそれを説明しています。
出典:Google Cloud 検索拡張生成(RAG)とは(2026年10月27日確認)。
資料の切り分け方も関係します。Anthropicは、切り出した文章だけでは会社や時期が分からなくなる例を示しています。売上の増減を示す一文が見つかっても、どの会社のどの時期の話かが欠ければ、その数字を使う判断ができません。
出典:Anthropic Contextual retrieval in AI systems(2026年10月27日確認)。
担当者の点検では、答えの読みやすさと、質問に合う資料を探せたかを分けて見ます。資料自体に答えがないのか、答えがあるのに該当部分を渡せなかったのかでも、見直す場所が違います。誤答をすべて文章の書き方の問題として扱わないことが要点です。
確認するときは出典へ戻り、答えに使った情報と元の内容を人が照合します。具体的な確かめ方は、生成AIの回答を元資料と照らし合わせる手順へ分けています。
また、用途との相性もあります。国のガイドラインは、RAGによって答えが似た方向へまとまりやすくなる点から、多彩な発想や独創性を求める仕事には適さないこともあるとしています。規程を調べて答える仕事と、新しい企画の幅を広げる仕事を、同じ目標で評価しないようにしましょう。
出典:総務省・経済産業省 AI事業者ガイドライン第1.2版 p.16 脚注29(2026年10月27日確認)。
社内の資料を読ませるときに気をつけることは?
資料を探す段階で、利用者が見てよい範囲へ制限する設計が必要です。 個人情報や外部の著作物を使ってよいかも、検索できるかどうかとは別に点検します。
Microsoft Learnは、アクセスの設計が不十分だと、機密の内容が、見てはいけない人にも回答を通じて見えてしまうおそれを説明しています。回答を受け取った後に伏せる発想だけでなく、検索する時点で閲覧権限を反映させる考え方です。
出典:Microsoft Learn 取得強化生成(RAG)とインデックス/Microsoft Learn Azure AI 検索でのレトリーバル拡張生成(RAG)(2026年10月27日確認)。
人事評価や給与の資料を、権限による制限なしに全社員向けの検索対象へ入れる場面を考えます。元の資料を直接開けない人にも、その内容がAIの回答に混ざって伝わるおそれがあります。資料ごとに閲覧を認める相手を決め、その範囲の内容だけを取得させます。
個人情報保護委員会は、事業者が個人情報を生成AIサービスへの入力に含める際はその利用目的の範囲内かを確かめることと、本人の同意を得ずに入力した個人データが回答作成とは別の目的にも使われると法に反するおそれがあることを注意喚起しています。
出典:個人情報保護委員会 生成AIサービスの利用に関する注意喚起等・別添1(2023年6月2日公表)(2026年10月27日確認)。
顧客や従業員の情報を扱うときも、RAGという方式を入力許可の根拠にはしません。入力する情報の線引きは、生成AIの情報漏えい対策と会社で決める基準へつなげます。
RAGの動作に再学習が要らないことと、サービスの提供元が送信データを学習へ使うかは別の問題です。後者は契約やプランで扱いが変わるため、ChatGPTの学習利用設定とプラン別の違いにある区別を参考に、利用先の公式条件を照合します。
社内で作った資料と、外部の書籍・有料記事・他社資料は区別して、使う権利を点検します。文化庁の整理にある著作権法47条の5の軽微利用や許諾の検討点は、生成AIと著作権の考え方で元資料とともに扱っています。
うちの会社はRAGを検討すべきか?
社内資料を調べ、その根拠を示して問い合わせに答える仕事なら、RAGを検討する接点があります。 資料を参照する必要があるか、検索を組むほどの量か、という順で見ます。
用途と、導入前に点検するところを分けると次のようになります。
| 任せたい仕事・条件 | 検討の方向 | 先に見るところ |
|---|---|---|
| 規程・就業規則・業務マニュアルへの問い合わせ | RAGと結び付きやすい | 参照すべき最新版をそろえる |
| 製品資料などの根拠を示して答える | 資料への参照を生かせる | 人が元の文書を開いて確かめられるか |
| 型番や規程番号を使って調べる | 検索方法の工夫が要る | 文字の一致も使って探せるか |
| 一部の人だけが読める資料を含む | 権限を組み込むことが前提 | 利用者ごとに検索対象を制限できるか |
出典:Microsoft Learn 取得強化生成(RAG)とインデックス/AWS RAG(検索拡張生成)とは何ですか?/Anthropic Contextual retrieval in AI systems(2026年10月27日確認)。
一方、資料を検索する以外の方法も検討したい用途があります。
| 目的・資料の状態 | 検討する別の方法 | RAGだけで考えない理由 |
|---|---|---|
| 資料が少なく、一度の入力に収まる | 資料をまとめて直接渡す | 検索する仕組みを設けず足りることもある |
| 企画案やコピーの発想を広げたい | 独創性を重視した使い方を考える | 資料に寄せることが目的に合わないこともある |
| 文体や仕事の型を変えたい | 指示の工夫やファインチューニング | 足りないのが知識とは別の要素だから |
出典:Google Cloud 検索拡張生成(RAG)とは/Microsoft Learn 取得強化生成(RAG)とインデックス/総務省・経済産業省 AI事業者ガイドライン第1.2版 p.16 脚注29(2026年10月27日確認)。
資料を直接渡す方法について、Anthropicは2024年9月時点の同社の説明で、資料のまとまりが小さければ全体を入力へ含める方法を示しています。Google Cloudも、モデルが一度に扱える量へ収まる資料なら、長い入力として渡す考え方を説明しています。
出典:Anthropic Contextual retrieval in AI systems/Google Cloud 検索拡張生成(RAG)とは(2026年10月27日確認)。
扱える量はモデルによって違うため、資料のページ数だけで方式を決めません。先に使用を認めた資料の範囲を決め、直接渡す方法で足りるのか、質問に合わせて関連部分を探す仕組みが要るのかを分けて考えます。
始める前に何を決めておけばいいか?
任せる仕事、資料の量、足りないもの、情報の扱い、人の確認、導入方法を順に整理します。 以下は各社や公的資料の論点を、社内で決める順へ並べたチェックリストです。
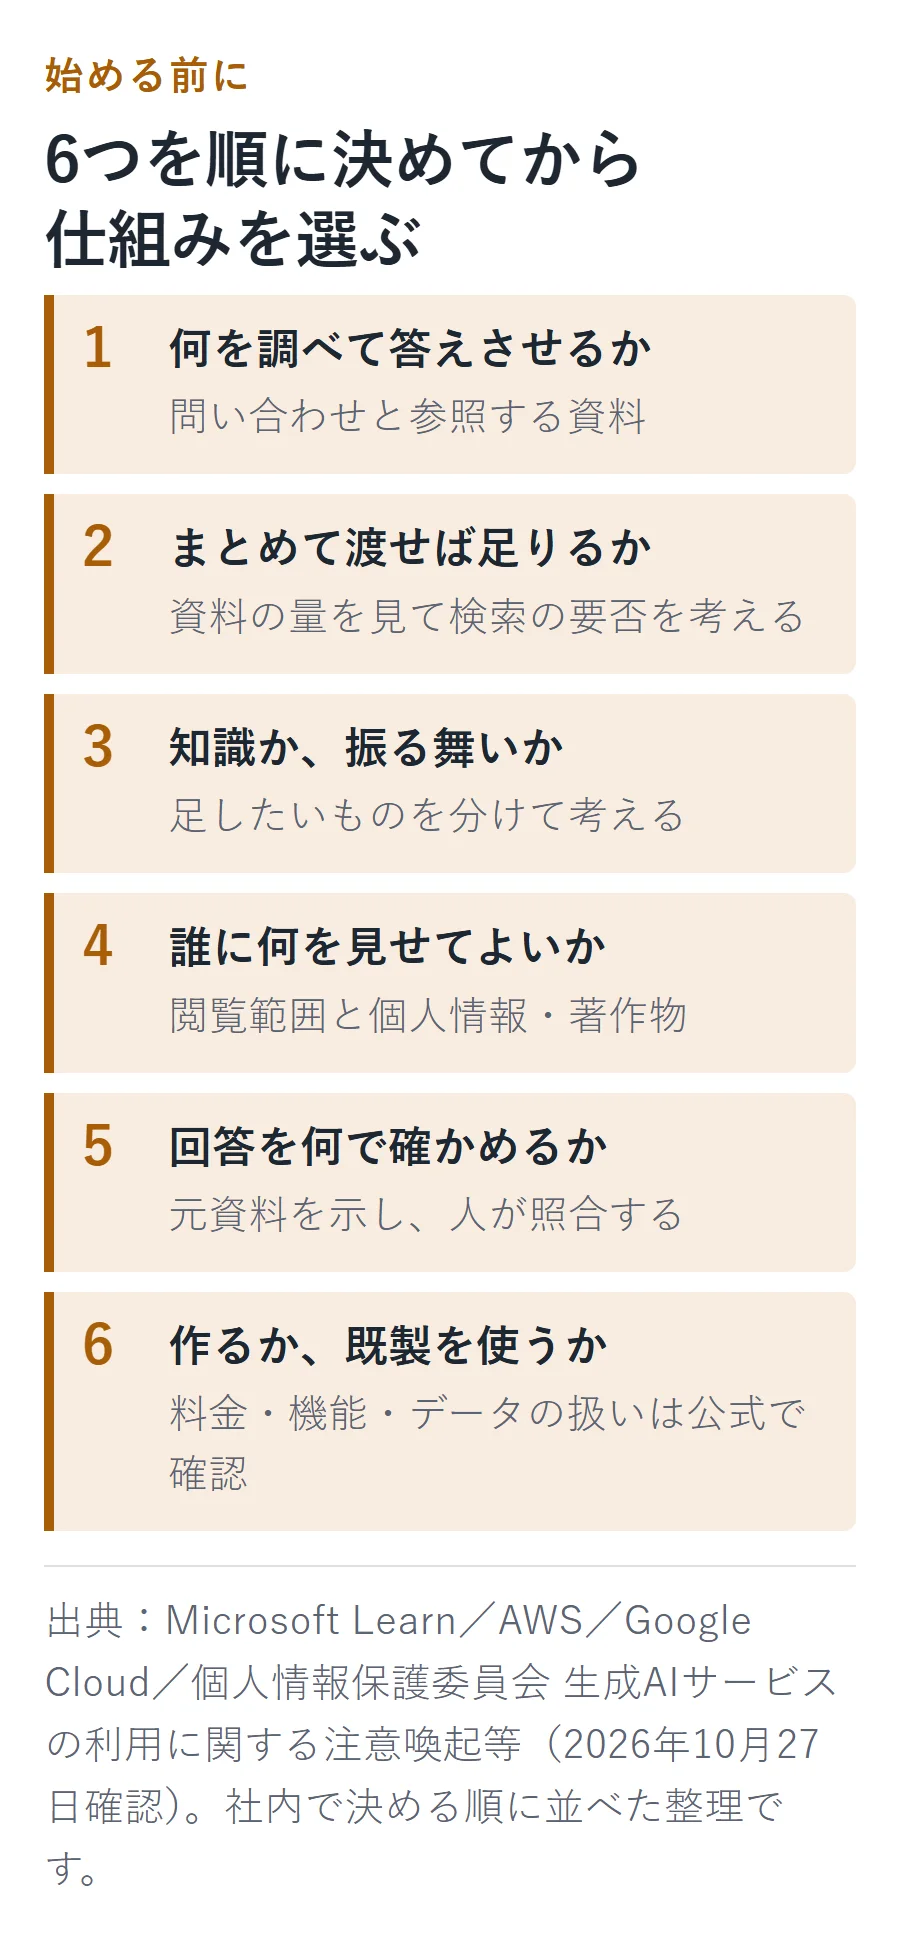
- 何を調べて答えさせるか。 問い合わせの種類と参照する資料を決めます。最新版を選ぶ人と、資料が変わったときに検索側へ反映する担当も書きます。
- 資料をまとめて渡す方法で足りるか。 使用を認める資料の量を見て、検索を組み込む必要があるかを考えます。小さな資料のまとまりまで、RAGありきで進めない判断です。
- 知識を足したいのか、振る舞いを変えたいのか。 社内情報の参照と、文体・書式・作業の型を調整する依頼を分けます。目的が両方にまたがるなら、手段も組み合わせて検討します。
- 誰に何を見せてよいか。 資料ごとの閲覧範囲を決めます。個人情報の利用目的や外部著作物の利用も点検し、検索対象に入れるという操作だけで判断を済ませません。
- 回答を何で確かめるか。 元資料を示し、人が内容を照合できる形を決めます。答えを使う担当が資料へ戻れなければ、出典を付ける利点を生かせません。
- 自社向けに作るか、既製のサービスを使うか。 上の条件を満たせるかを検討します。料金・機能・データの扱いは各社の公式ページで確認してください。
出典:Microsoft Learn 取得強化生成(RAG)とインデックス/AWS RAG(検索拡張生成)とは何ですか?/Google Cloud 検索拡張生成(RAG)とは/個人情報保護委員会 生成AIサービスの利用に関する注意喚起等(2026年10月27日確認)。
検討の結果は、製品名だけのメモで終えず、「この仕事に、この資料を、この範囲の人が使う」と読める形にします。問い合わせを受ける担当と、元資料を管理する担当が同じ前提を持てるようにするためです。
決めたことを会社の取り決めへ反映する段階は、生成AIの社内ルールに利用範囲と確認責任を書く方法へつなげます。仕組みを選ぶ作業と、日々の資料更新や回答確認を引き受ける作業を、一緒に進めましょう。
よくある質問
誤った情報源を参照していたら、何を見直しますか?
AWSは、RAGで使う情報源を管理し、誤ったものを参照していれば修正できる点を説明しています。対応案として、問題になった回答とその参照先を資料の管理担当へ渡し、どの情報を直すかを特定する形が考えられます。すべての誤答を同じ原因と決めず、参照先の修正で対応する部分を分けます。
出典:AWS RAG(検索拡張生成)とは何ですか?(2026年10月27日確認)。
社内向けにRAGを作る会社も、AI利用者の項だけを読めばよいですか?
使う会社であることに加え、社内へ仕組みを作って提供する立場にも目を向けます。AI事業者ガイドラインの立場の区分に照らすと、自社の関わり方に応じて開発者・提供者向けの項も読む対象になります。既製のサービスを使う業務と、自社で仕組みを用意する業務を分けて整理しましょう。
出典:総務省・経済産業省 AI事業者ガイドライン第1.2版(2026年10月27日確認)。
出典を示す考え方は、公的な指針にもありますか?
内閣府の「人工知能関連技術の研究開発及び活用の適正性確保に関する指針」は、透明性に関する説明で、出力の根拠となったウェブサイトなどを示す方向を挙げています。社内の仕組みでも、回答の文章だけでなく、何を参照したかを利用者へ伝えるという設計上の観点につながります。
出典:内閣府 人工知能関連技術の研究開発及び活用の適正性確保に関する指針 p.5 脚注17(2026年10月27日確認)。
まとめ
RAGは、モデルを学習し直す代わりに資料を探して回答へ使う方法で、振る舞いを変えるファインチューニングとは役割が異なり、併用もできます。
社内資料で検討するなら、資料の量・最新版・閲覧権限・使う権利を整理し、検索の質と人が根拠を確かめる運用をセットにしましょう。
出典を示せても誤りは残ります。2026年10月27日時点の整理を踏まえ、導入時の料金・機能・データの扱いは各社の公式ページで確かめます。